Coding-Assistenten: Machen sie mich dümmer?
Habe ich noch alles unter Kontrolle? Weiß ich wirklich, was ich tue? In letzter Zeit muss ich mir diese Fragen immer öfter stellen. Der Grund für mein Unbehagen: Coding-Assistenten oder, allgemeiner gesagt, KI.
Als professioneller Webentwickler nutze ich bereits seit mehreren Jahren KI-Tools. Anfangs war ich zurückhaltend, ja sogar skeptisch. Die ständigen Halluzinationen und der oft veraltete Code, den generative KI produzierte, waren für mich ein No-Go. Hinzu kommen noch die Auswirkungen auf die Umwelt und die psychische Gesundheit. Einfach grauslich!
Foto: © Alex Knight / pexels.com
Aber die Tools wurden immer besser. Mein Arbeitgeber ermutigte mich immer wieder, den GitHub Copilot KI-Assistenten zu nutzen, den er mir zur Verfügung gestellt hatte. Also gab ich langsam nach.
Nur um das klarzustellen: Ich bin (noch) weit davon entfernt, ein „Vibe-Coder“ zu sein, der nicht einmal mehr seinen eigenen Code liest. Aber ich muss ehrlich zu mir selbst sein: KI-Tools sind zu einem festen Bestandteil meiner täglichen Arbeit geworden. Und manchmal habe ich das Gefühl, dass ich die Kontrolle verliere. Dass meine Abhängigkeit von KI mich dümmer macht.
Deshalb habe ich beschlossen, darüber zu schreiben. Um einige meiner Gedanken und Befürchtungen mit der Welt zu teilen.
GitHub Copilot: Mein übereifriger Assistent
Bei der Arbeit nutze ich hauptsächlich GitHub Copilot als meinen Coding-Assistenten. Ich kann in Visual Studio Code ein eigenes Fenster öffnen, aus einer Liste von LLM-Modellen auswählen und mit der Eingabe von Prompts beginnen. Ich verwende schon seit langer Zeit Claude-Modelle wie Opus und Haiku. In letzter Zeit bin ich auf die neuesten OpenAI-Modelle wie GPT-6 Sol und Luna umgestiegen.
Sind die OpenAI-Modelle besser als Claude? Ich weiß es wirklich nicht. Meine Theorie ist, dass ich einfach eine Schwäche für Science-Fiction-Schlagwörter habe.
Wie auch immer: Wie ist es, mit GitHub Copilot zu arbeiten? Und glaube ich, dass ich davon profitiere, oder macht es mich auf lange Sicht dümmer? Hier sind ein paar Beobachtungen, die ich gemacht habe.
Die simplen Aufgaben
Es gibt einige Aufgaben, die mir mehr Spaß machen als andere. Ich liebe es, gemeinsam mit Kunden ein bestehendes Problem zu analysieren und unsere Ideen in klare und präzise Anforderungen umzusetzen. Ich arbeite sehr gerne gemeinsam mit der UI/UX-Abteilung an Entwürfen, definiere eine effiziente Architektur für eine Anwendung oder implementiere komplexe Funktionen.
Ich mag es überhaupt nicht, Unit-Tests zu schreiben. Oder Mock-Daten zu generieren, weil das eigentliche Backend noch nicht fertig ist. Oder das Allerschlimmste: eine kryptische Fehlermeldung zu analysieren, und dabei Stunden damit zu verschwenden, Blogs und Fragen auf Stack Overflow durchzulesen.
In solchen Situationen zögere ich keine Sekunde, die Aufgabe an Copilot zu übergeben. Das ist mittlerweile ein Reflex, reines Muskelgedächtnis. Und die KI liefert in der Regel gute Ergebnisse. Ich weiß, wie ich den Prompt richtig formuliere und wie ich die passenden Rahmenbedingungen festlege.
Funktioniert das immer? Nein. Führt mich die KI manchmal in die Irre? Auf jeden Fall. Aber meistens hilft sie mir dabei, das Problem zu lösen oder meine Aufgabe schneller zu erledigen, als wenn ich es alleine machen würde.
Außerdem gelten bei uns strenge Review-Regeln: Entwickler:innen müssen ihren eigenen Code überprüfen und verstehen – das gilt auch für Code, der von einem LLM generiert wurde. Zudem muss jede Änderung an der Codebasis von einer anderen Person überprüft werden, bevor der Pull-Request zusammengeführt werden kann. Jede einzelne Codezeile unterliegt (zumindest theoretisch) einer menschlichen Beurteilung.
Sag mir wer ich bin
Meine bisher wichtigste Erkenntnis lautet: Coding-Assistenten lieben es, sich auszutoben! Sie neigen dazu, es zu übertreiben.
Große Sprachmodelle (LLMs) sind sehr anpassungsfähige Systeme. Man muss klare Regeln definieren und Grenzen setzen, wenn man möchte, dass das LLM konsistenten und robusten Code generiert. In unseren Angular-Projekten beginnen wir immer mit einer Regeldatei, die der KI Folgendes vorgibt:
You are an expert in TypeScript, Angular, and scalable web application development. You write functional, maintainable, performant, and
accessible code following Angular and TypeScript best practices (and so forth)
Je nach konkretem Projekt und Konfiguration legen wir außerdem zusätzliche Anweisungen fest. Zum Beispiel: Use the project’s custom dialog service based on the native HTML dialog element to create dialog components. Do NOT use Angular Material dialogs!
Auf der Grundlage dieser Basis-Anweisungen führt jede Eingabe, die ich im Chat-Fenster von GitHub Copilot mache, mit größerer Wahrscheinlichkeit zu generiertem Code, der unseren Qualitätsstandards entspricht.
Ein guter Plan ist die halbe Miete
Wenn ich ein neues Feature implementiere, beginne ich in der Regel im Planungs-Modus. Auf diese Weise kann ich gemeinsam mit meinem Coding-Assistenten einen Plan entwerfen, bevor dieser auch nur eine einzige Datei im Quellcode anfassen darf. Dieser Prozess ist tatsächlich sehr hilfreich und führt meiner Erfahrung nach letztendlich zu besseren Ergebnissen.
Um euch ein konkretes Beispiel zu nennen: Vor einigen Wochen habe ich an einer Vektorkarten-Komponente gearbeitet, welche die MapLibre-GL-Bibliothek nutzt. Die Komponente wandelt ein Konfigurationsobjekt in eine interaktive Karte um. Man kann verschiedene Layer sowie Marker für relevante Orte hinzufügen.
Ich wollte nun einen Mechanismus implementieren, der die Definition einer strengen Layer-Reihenfolge vereinfacht. Etwas, das MapLibre selbst leider nicht bietet. Ich hatte bereits eine Liste mit Anforderungen und architektonischen Ideen erstellt. Diese nutzte ich also als Ausgangspunkt für mein Gespräch mit GitHub Copilot – genauer gesagt mit dem leistungsstarken GPT-6-Sol-Modell.
Die gesamte Planungssitzung dauerte etwa eine Stunde. Copilot verarbeitete die Anforderungen, analysierte den bestehenden Code und recherchierte MapLibre selbst mithilfe von HTTP-Anfragen an dessen Website. Es stellte mir mehrere Fragen. Fragen zu Implementierungsdetails, über die ich noch gar nicht nachgedacht hatte. Ich war beeindruckt!
Nach mehreren Feedbackrunden war ich mit dem Plan zufrieden und wies Copilot an, in den Agentenmodus zu wechseln und das Feature zu implementieren. Innerhalb weniger Minuten generierte das Programm tausende Zeilen Code, darunter Dutzende von Unit-Tests. Die atemberaubende Geschwindigkeit von LLMs ist einfach unglaublich … und auch ein bisschen beängstigend.
Ich muss ehrlich sein: Es war anstrengend, den gesamten generierten Code durchzugehen! Das ist etwas anderes, als Code zu lesen, den man selbst geschrieben hat. Denn den eigenen Code kennt man bereits, man hat ihn schon einmal bewusst verarbeitet. Generierter Code hingegen ist wie eine riesige Informationsflut, die einen wie eine hereinbrechende Welle auf dem Meer überrollt.
Aber ich muss den generierten Code überprüfen. Ich muss ihn verstehen. Ich muss meinen Kolleg:innen erklären können, wie er funktioniert. Zum Glück musste ich auch die Dokumentation für das neue Feature verfassen und es in unserer internen Demo-Anwendung einsetzen. Die Vektorkarten-Komponente ist Teil einer Angular-Bibliothek, die wir pflegen und regelmäßig um neue Funktionen erweitern.
Ich glaube nicht, dass mich die Nutzung von GitHub Copilot auf diese Weise dümmer oder zu einem schlechteren Entwickler gemacht hat. Der Einsatz von Coding-Assistenten und LLMs im Allgemeinen birgt sicherlich diese Gefahr. Ich denke, man muss dieser Gefahr eines kognitiven Verfalls aktiv entgegenwirken. Man muss planen und den generierten Code überprüfen. Man muss sein großes Gehirn auch einsetzen!
Update meines Webservers mit ChatGPT
Vor etwa einer Woche zwangen kritische Sicherheitslücken in PHP Unternehmen weltweit dazu, ihre Websites umgehend zu aktualisieren oder vorübergehend offline zu nehmen. Andernfalls hätten Hacker die Sicherheitslücken ausnutzen können, um die Kontrolle über betroffene Webserver zu erlangen und sensible Daten zu stehlen.
Am Mittwoch, dem 21. Oktober, folgte dann der nächste Super-Gau: Node.js, die Open-Source-JavaScript-Laufzeitumgebung, gab bekannt, dass in ihrer neuesten Version gerade vier Sicherheitslücken mit hohem Schweregrad behoben wurden. Eine dieser Sicherheitslücken ermöglichte zudem die Ausführung von Remote-Code.
Das hat mich zum Nachdenken gebracht: Ist mein Webserver gefährdet? Ich betreibe eine einfache Node.js-Anwendung, die diesen Webblog bereitstellt. Könnte jemand die Sicherheitslücken ausnutzen, um meinen Server zu kapern?
Das war der Beginn einer abenteuerlichen Reise, auf der ich meinen Ubuntu-Server, Node.js und andere Abhängigkeiten mit Hilfe von ChatGPT aktualisiert habe. Die Mission war ein voller Erfolg. Aber am Ende habe ich mich gefragt: „Hätte ich das auch ohne KI geschafft?“ Es folgt eine Geschichte in drei Akten.
Akt 1: Wie ein Fisch auf dem Trockenen
Ich bin ein Frontend-Webentwickler. Bei der Arbeit überlasse ich die Backend- und Datenbankaufgaben normalerweise meinen Kolleg:innen. Also, ja: Die Aussicht, mich per SSH mit meinem Server zu verbinden und verschiedene kryptische Befehle in der Shell auszuführen, hat mich NICHT gerade mit Freude erfüllt! Ich habe mich unwohl gefühlt. Wie ein Fisch auf dem Trockenen.
Zunächst habe ich nach Online-Tutorials gesucht, die mich durch den ganzen Prozess führen würden. Aber dann dachte ich mir: Hey, es gibt da diese tolle Sache, mit der man in einfacher Sprache sprechen kann und maßgeschneiderte Antworten erhält. Also habe ich eine neue ChatGPT-Sitzung gestartet und meine Lage geschildert.
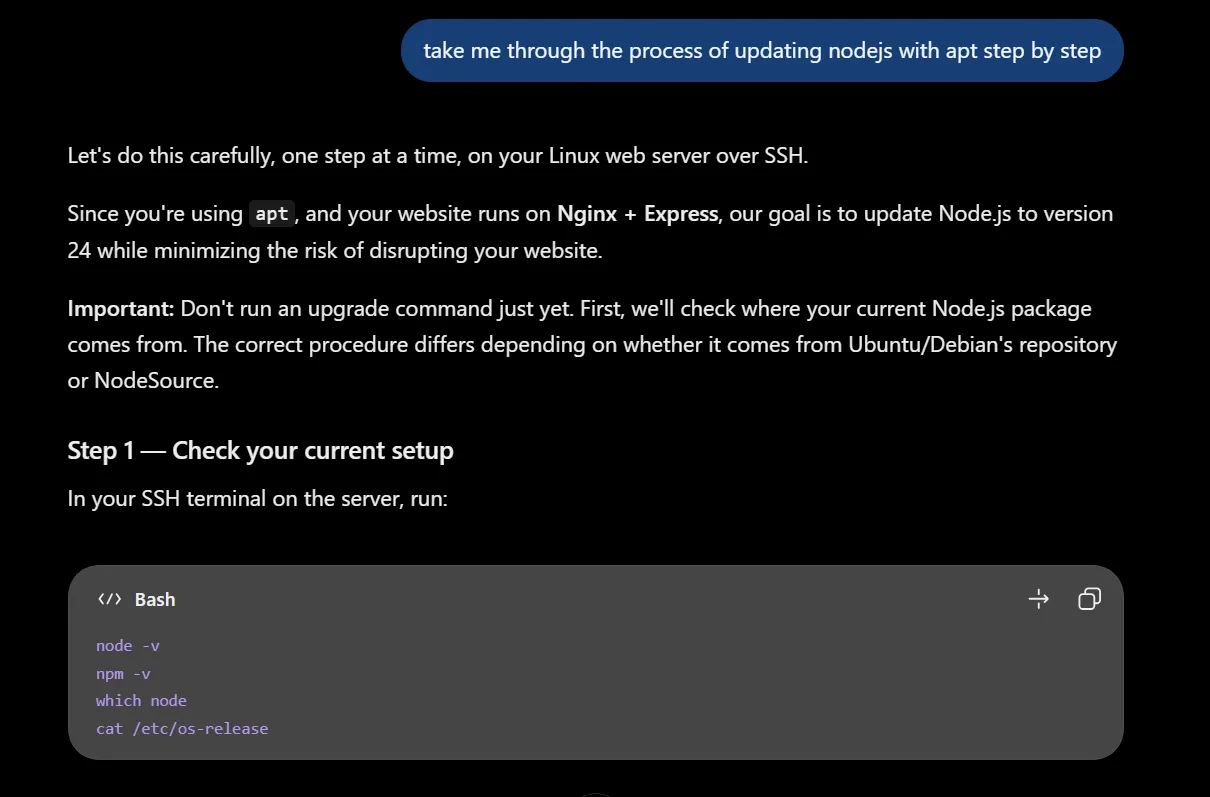
Meine erste Frage lautete: „Kann es zu Problemen mit anderen Programmen kommen, wenn ich Node.js auf meinem Webserver aktualisiere?“ Die KI antwortete. Sie nahm mich an die Hand und führte mich Schritt für Schritt durch den Prozess.
Screenshot: © ChatGPT / OpenAI
Akt 2: Euphorie
Es stellte sich schnell heraus, dass meine alte Node.js-Version noch das geringste meiner Probleme war. Ich arbeitete immer noch mit Ubuntu 18.04, einer völlig veralteten Version, die nicht einmal die aktuelle Node.js 24 LTS-Version unterstützt. Ups… Na ja, ich habe ja erwähnt, dass ich lediglich ein Frontend-Entwickler bin (peinliches Räuspern).
Wie auch immer. ChatGPT hat mich nicht ausgelacht. Es hat mich auch nicht dafür kritisiert, dass ich meinen Webserver so lange vernachlässigt habe. Es hat mich lediglich gebeten, ein paar Überprüfungen durchzuführen, und mir dann einen detaillierten Plan vorgelegt: Ubuntu Release für Release aktualisieren, dann Node.js und den Rest.
Das ist, ehrlich gesagt, einer der größten Vorteile der KI: Sie steht dir jederzeit zur Seite und beantwortet deine Fragen. Sie wird weder ungeduldig noch genervt. Natürlich kann es vorkommen, dass sie sich Dinge ausdenkt oder dich auf die falsche Fährte führt. Deshalb musst du wachsam bleiben und die Informationen kritisch hinterfragen.
Ich habe ChatGPT auch nicht einfach die Zugangsdaten zu meinem Webserver überlassen. Ich habe jeden Befehl persönlich in der Shell ausgeführt. Wenn ich auf ein Problem stieß, habe ich die Ausgabe wieder an ChatGPT weitergeleitet. Mein erster Versuch, Ubuntu von 18.04 auf 20.04 zu aktualisieren, schlug beispielsweise mit der folgenden Fehlermeldung fehl:
Broken nodejs:amd64 Depends on python-minimal:amd64 < 2.7.15~rc1-1 @ii gR >
Broken python2-minimal:amd64 Breaks on python-minimal:amd64 < 2.7.15~rc1-1 @ii gK > (< 2.7.15-2) …
Ich kopierte die Nachricht ins Chatfenster. ChatGPT erklärte mir, dass es aufgrund der alten Node.js-Version 18 und ihrer Abhängigkeiten zu einem Konflikt gekommen sei. ChatGPT riet mir, Node.js zunächst zu deinstallieren und es später, nach dem Upgrade von Ubuntu, erneut zu installieren. Es warnte mich, dass ich mich auf einen vorübergehenden Ausfall meiner Backend-Anwendung und damit auch meines Webblogs einstellen müsse.
Ich stimmte zu und folgte den Anweisungen. Ich führte Befehle wie sudo apt remove nodejs
und dpkg -s nodejs gewissenhaft aus. Der Chatbot erklärte jeden Schritt so ausführlich, dass ich mich sicher fühlte.
Es half auch, dass ich mit grundlegenden Linux-Befehlen vertraut bin. Ich sagte mir: „Ich weiß, was ich tue!“
Dann erreichte ich meinen ersten Meilenstein: Nach etwa einer Stunde war der Upgrade-Vorgang auf Ubuntu 20.04 abgeschlossen. Ich war total begeistert! Mein Vertrauen in die Fähigkeiten des Chatbots wuchs. Ich begann, den Anweisungen, die ich erhielt, blind zu folgen. Selbst wenn ich nicht jedes Detail des Befehls verstand, wie zum Beispiel:
grep -RniE 'nodesource|certbot|droplet-agent' /etc/apt/sources.list.d/ 2>/dev/nullWas spielte das schon für eine Rolle? Es hat funktioniert. Das ist doch alles, was zählt, oder?!
Und so ging es mehrere Stunden lang weiter: ChatGPT sagte mir, was ich tun sollte, und ich tat es. Ich erstattete meinem KI-Oberherrn stets Bericht und erhielt regelmäßig ermutigendes Feedback wie: “Excellent! 🎉”
Akt 3: Selbstzweifel und Schamgefühl
Manchmal zögerte ich. Ich fragte mich: „Weiß ich wirklich, was ich da tue? Habe ich noch die Kontrolle?“ Es war seltsam. Manchmal kam ich mir vor wie ein ferngesteuerter Fleischklumpen, der die Befehle der KI auf dem Server ausführte und die Ergebnisse zurückmeldete. Ein rhythmisches Hin und Her, mit mir in der Mitte: ein glücklicher, leichtgläubiger Narr, der seine Handlungsfähigkeit aufgab.
Zu viel? Ein bisschen melodramatisch? Vielleicht, ja. Aber im Grunde genommen ist es auch die Wahrheit – zumindest meine persönliche Wahrheit. So, wie ich es gerade empfinde.
Die Sache ist die: Ich habe eigentlich nichts Neues gelernt. Ich kann mich nicht mehr an alle Befehle erinnern, die ich ausgeführt habe.
Ich bin nicht auf magische Weise zum Experten für die Verwendung von grep, apt
und systemctl auf einem Linux-Server geworden. Stattdessen habe ich meinen Lern- und Problemlösungsprozess an
den LLM-Chatbot ausgelagert.
Ein paar Gedanken zum Schluss
Seid ihr immer noch da? Cool, danke fürs Durchhalten.
Wie lautet also mein großes Fazit? Glaube ich, dass der Einsatz von Coding-Assistenten mich dümmer macht? Ehrlich gesagt, weiß ich es nicht. Ich denke, dass definitiv ein gewisses Risiko besteht. Aber wie bei allen Werkzeugen kommt es immer darauf an, wie man sie einsetzt.
Ich schließe daher diesen (viel zu langen) Beitrag einfach mit einem Zitat aus diesem Artikel ab:
The comfort we get when offloading our cognitive load to LLMs is bad for us. Cognitive load should exist, and if we reduce it too much
— if we stop thinking — we can actually unlearn how to think.
Erstellt am